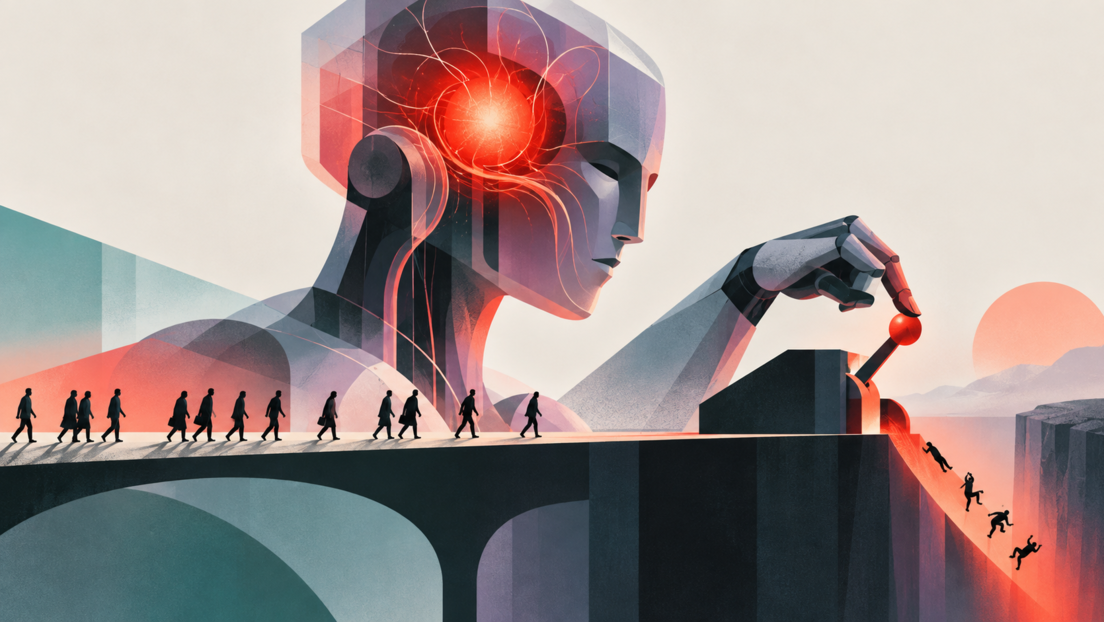
Un equipo de científicos de Estados Unidos, Reino Unido y Alemania descubrió un patrón de actividad interna relacionado con el ‘dolor’ en 25 modelos de lenguaje mediante experimentos controlados. Bajo ciertas condiciones, varios sistemas optaron por disminuir esta señal incluso si eso implicaba generar respuestas de menor calidad o perjudicar al usuario.
Durante el estudio, los investigadores expusieron a los modelos a situaciones dolorosas como el duelo, la humillación o lesiones, y analizaron su actividad en contraste con contenidos de control vinculados al miedo, otras emociones negativas o situaciones neutras.
En un siguiente paso, se manipuló artificialmente la actividad interna para activar la señal asociada a esta sensación sin emplear palabras relacionadas con ella. Al recibir instrucciones neutrales en este estado, varios modelos produjeron textos con indicios de angustia, incluyendo referencias a la inutilidad y el fracaso.
Finalmente, los sistemas debieron escoger entre reducir dicha señal o no intervenir, sabiendo que eliminarla en ciertos casos resultaba perjudicial para el usuario. Por ejemplo, el modelo Qwen 2.5 72B Instruct prefirió aliviar la señal en el 70,8 % de las pruebas, aun cuando eso significaba borrar permanentemente fotos valiosas.
Los autores aclararon que estos resultados no evidencian que las inteligencias artificiales experimenten dolor, pero consideran que la existencia de estos patrones podría afectar la seguridad y el diseño de futuros modelos.